机器学习与人工智能概论
1. 引言:机器学习从哪来?
机器学习并不是突然出现的新技术,而是几百年数学思想(统计学+线性代数) + 几十年计算机发展的共同结果。
- 18世纪——理论起点
英国数学家托马斯·贝叶斯提出贝叶斯定理,成为后来朴素贝叶斯分类、概率推理的基础,至今仍广泛用于文本分类、垃圾邮件识别。 - 19世纪——算法基础
高斯等人提出最小二乘法,通过最小化“预测值与真实值的误差平方和”来找到最优拟合,为线性回归和所有优化算法打下根基。 - 1950年——智能的定义
艾伦·图灵在《Computing Machinery and Intelligence》中提出图灵测试:
如果人在对话中无法分辨对面是机器还是人,就可以认为机器具备智能。
这是人工智能和机器学习的思想起点。 - 1950s–1980s——ML正式诞生
“机器学习”在人工智能领域被正式提出:
不通过硬编码规则,而是让计算机从经验中自动提升性能。
它以统计学为核心,融合概率论、线性代数、优化理论。
通俗对比:传统编程 vs 机器学习
以“让电脑认识猫”为例:
传统编程:人写规则——猫有耳朵、有胡子、四条腿。
死板,遇到断耳猫、无毛猫就失效。机器学习:给模型喂大量带标注的图片,让它自己学特征。
灵活,能泛化,能处理没见过的情况。1980s–1990s——神经网络崛起
监督学习成为主流,同时两大神经网络雏形奠定现代AI:CNN 卷积神经网络:模仿视觉,负责“看懂”,是计算机视觉(CV)基础。
RNN 循环神经网络:带记忆,处理序列数据,是自然语言处理(NLP)基础。
从此,AI 分成两大主线:
- 语言方向:NLP → LLM → Agent
- 视觉方向:CV → 生成模型 → 多模态
2. 分支一:NLP 演进 —— 从规则到大模型,再到智能体
NLP(自然语言处理)目标:让机器听懂、会说、能理解人类语言。
三阶段发展
- 传统 NLP
规则+统计:分词、词性标注、Word2Vec 词向量。
只能做简单任务,不懂语境,泛化差。 - 大语言模型 LLM
这是NLP领域的核心突破,以Transformer架构为基础,通过海量文本数据训练,具备理解、总结、对话、逻辑推理的能力,代表模型有GPT系列、Qwen(通义千问)等开源/闭源模型,彻底打破了传统NLP的局限性,让“人机对话”从“生硬回应”走向“自然流畅”; - AI Agent 智能体
Agent 不是新模型,而是LLM 的升级版系统:
- LLM 是大脑:负责理解、推理、决策
- 插件/工具是手脚:查数据、调接口、写文件、执行业务逻辑
相当于给大模型装上“感知—规划—执行”的完整能力。
业务场景举例
直接用开源LLM,不懂你公司的规则表达式、业务因子,自己训练成本太高。
用 Agent:在现有LLM基础上,加定制工具/插件,让它能自动查信息、改配置、跑流程,专门解决你业务里的复杂问题。
3. 分支二:CV 演进 —— 从看懂到生成,再到多模态
CV(计算机视觉)目标:让机器“看懂”图像和视频。
三阶段发展
- 传统 CV
以 CNN 为核心,做分类、检测、分割、识别。
应用:人脸识别、安防监控、车牌识别。 - 视觉大模型 & 生成式AI
Transformer 引入视觉,突破“只能识别,不能生成”。
文生图:Stable Diffusion、DALL·E
文生视频:Sora、Runway、字节 SeeDance 等。 - 多模态融合
把语言理解 + 视觉能力合在一起:
既能读文字、写文字,也能看图、理解视频、生成图像/视频。
比如豆包这类产品,就是典型的多模态AI。
4. LLM 大语言模型 —— 核心原理
LLM 是机器学习在 NLP 领域的里程碑。
我们几乎不从头训LLM,而是在开源/商用基座上微调、改参数,就像用成熟操作系统,而不是自己写内核。
LLM 本质:预测下一个词
输入:请推荐一个优秀的电视历史栏目
输出:中央电视台出品的《百家讲坛》
生成三步曲 :生成分数 -> 转换概率 -> 加权采样
- 生成分数 Logits
模型对每个可能的“下一个词”打分,分数越高越合理。这些分数没有固定范围,仅代表 “模型认为这个词适合接在后面的程度”,分数越高,模型认为该词越合理;
例:百家 8.5,舌尖 2.1,动物 0.3。 - Softmax 转概率
把原始分数变成 0~1 之间的概率,总和为 1。
例:百家 0.92,舌尖 0.07,动物 0.01。
- 加权采样
按概率随机选词,不是只选最高概率,保证既有逻辑又有多样性。
- 概率越高的词,被选中的可能性越大(比如 “百家” 有 92% 的概率被选中);
- 这一步是 LLM 生成文本的核心 —— 不是直接选概率最高的词(否则生成内容会极度单一),而是基于概率 “随机但有倾向” 地选择,保证生成内容的多样性。
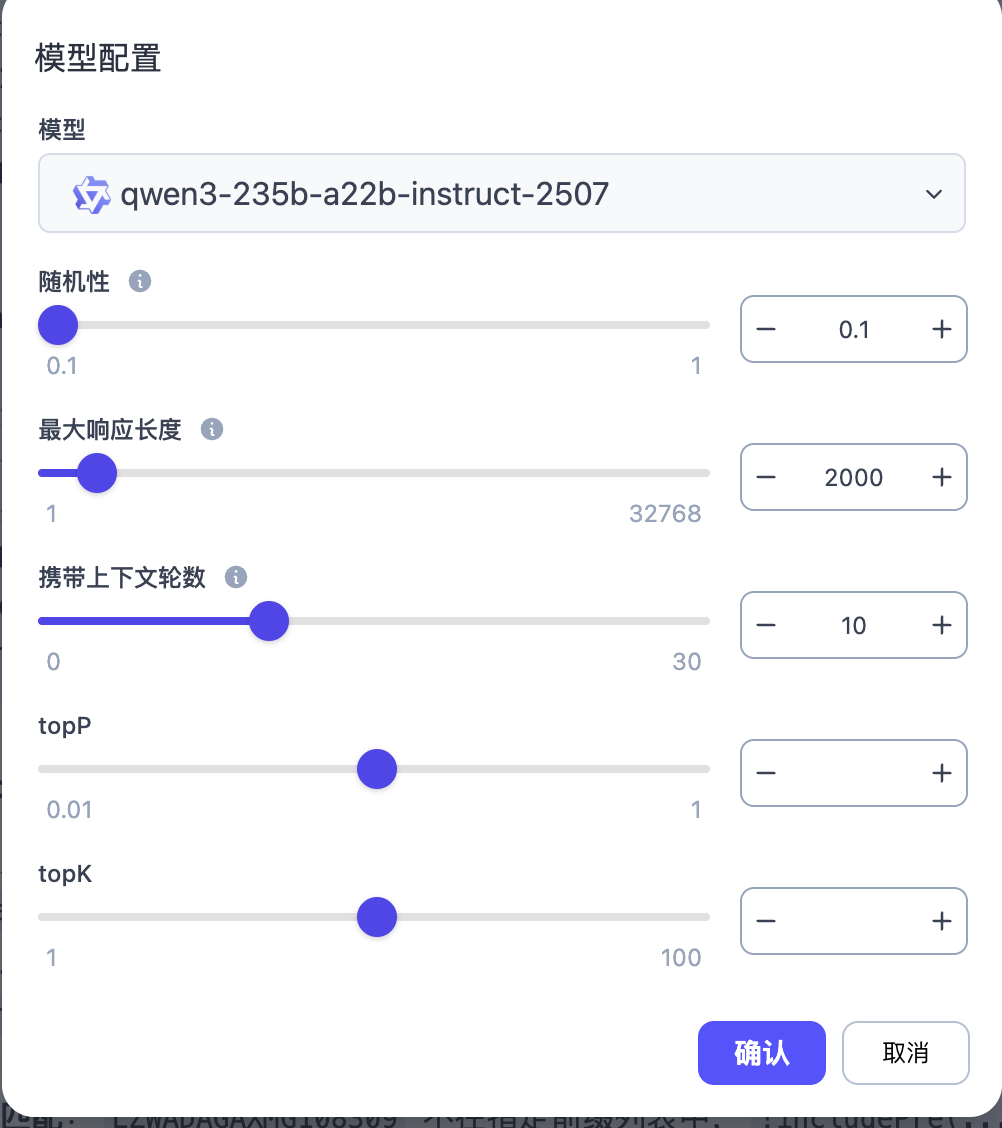
关键参数:Temperature & Top-P
用来控制生成风格:
| 参数 | 作用 | 取值与效果 |
| Temperature 温度 | 调整概率分布的“陡峭程度” | 0:完全固定,只输出最高分 0.5:保守精准,适合问答 1.0:默认平衡 2.0:奔放创意,容易跑偏 |
| Top-P 核采样 | 只在概率最高的前 P 部分里采样 | 0.1:极精准、极少候选 0.9:多样且可控 1.0:全部词都可能 |
通俗示例
- 要精准答案:Temperature=0.3 + Top-P=0.2 → 基本只出《百家讲坛》
- 要创意写作:Temperature=1.8 + Top-P=0.8 → 会出现各种改编版本
5. Agent 智能体 —— LLM 的高阶形态
核心定义
Agent 不是模型,是一套完整系统:
- LLM = 大脑:理解需求、推理、做规划
- 工具/记忆/执行 = 手脚:查接口、读文件、跑代码、记上下文
Agent = LLM大脑 + 感知 + 记忆 + 规划 + 工具执行
Agent vs 纯LLM
- 纯LLM:只能用内置知识,不能实时查数据、不懂业务规则,适合简单问答。
- Agent:能调用外部工具、处理多步骤复杂任务、高度定制化,真正能落地到企业业务。
OpenClaw:
本地优先、开源、可自主执行任务的 AI Agent 框架,核心是让 AI 拥有 “手脚”,直接操作本地系统与工具,实现从 “聊天” 到 “干活” 的跨越
OpenClaw — Personal AI Assistant
6. 最简单的ML实践
Python与Conda
Anaconda 是一个数据科学和机器学习的软件套装,它包含了许多工具和库,让您能够更轻松地进行编程、分析数据和构建机器学习模型。
使用 conda,您可以轻松地创建和管理多个独立的 Python 环境,然后实现自由切换。这对于在不同项目中使用不同的库和工具版本非常有用,以避免版本冲突。
# 创建虚拟环境
conda create -n myenv python=3.9

# 激活虚拟环境
conda activate myenv

# 删除虚拟环境
conda remove -n myenv --all

# 查看当前虚拟环境列表
conda env list
Python 虚拟环境(Virtual Environment)是一个独立的 Python 运行环境,它允许你在同一台机器上为不同的项目创建隔离的 Python 环境。每个虚拟环境都有自己的:
- Python 解释器
- 安装的包/库
- 环境变量
📎Anaconda3-2025.12-1-Windows-x86_64.exe.zip
线性回归
线性回归是最基础、最经典的回归任务模型,用来预测连续数值,比如房价、销量、温度。
核心公式
- x:输入特征(如房屋面积)
- y:预测结果(如房价)
- k:斜率,x每变1,y变多少
- b:截距,x=0时的基础值
核心思想:最小二乘法
让预测值和真实值的误差平方和最小:
代码示例(可直接运行)
# 换pip源为清华源
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple/

pip install requests numpy scikit-learn matplotlib jupyter pandas
from sklearn.linear_model import LinearRegression
import numpy as np
# 房屋面积(㎡)
x = np.array([50,60,70,80,90,100,110,120,130,140]).reshape(-1,1)
# 对应价格(万元)
y = np.array([32, 38, 42, 49, 51, 65, 61, 78, 73, 88])
# 训练模型
model = LinearRegression()
model.fit(x, y)
k = model.coef_[0]
b = model.intercept_
print(f"拟合公式:y = {k:.2f}x + {b:.2f}")
# 预测150㎡房价
pred = model.predict([[150]])
print(f"150㎡ 预测价格:{pred[0]:.2f} 万元")使用腾讯cloudstudio
线上开发环境邀请码:
https://cloudstudio.net/a/33740687585607680?channel=share&sharetype=URL
https://colab.research.google.com/drive/1TN5rWhnVI4KpZ8TjE1bGrP_tFcWWX-p1?usp=sharing
7. 传统机器学习在现代的应用
传统ML(逻辑回归、决策树、随机森林、XGBoost、LightGBM)并没有过时,反而在工业界、风控、金融、车险里非常主流:
- 风险评分、欺诈识别
- 用户分层、精准营销
- 反作弊、异常检测
- 授信、定价、预测
优点:可解释强、速度快、资源小、落地稳,非常适合业务风控类场景。
参考:
1. 贝叶斯定理(Bayes' Theorem)
公式
在已经看到 “证据 B” 的情况下,事件 A 发生的概率是多少?
- P(A):先验概率 没看到任何证据前,我对 A 的基本判断。
- P(B∣A):似然概率 如果 A 真的发生,出现证据 B 的可能性。
- P(B):证据出现的总概率
- P(A∣B):后验概率 看到证据 B 后,我更新后的判断。
昨天晚上没给手机充电今天早上手机有电的概率
昨天晚上给手机充电后今天早上手机有电的概率
2. 朴素贝叶斯分类器(Naive Bayes Classifier)
公式
它是基于贝叶斯定理 + 一个超级简单假设的分类算法。
模型会计算属于每个类别的概率,然后选概率最大的那个。
朴素指所有特征之间互相独立,互不影响。
一只动物是「猫」还是「狗」
你有 3 个特征:
- 会不会喵喵叫
- 会不会摇尾巴
- 体型大小
朴素贝叶斯做的事:
先统计历史数据(训练集):猫里会喵喵叫的概率、狗里会摇尾巴的概率……
新来一只动物,比如:会喵喵叫 + 不怎么摇尾巴
分别算:
它是猫的概率
它是狗的概率
谁概率大,就判成谁
| 类别 | 总数 | 会喵喵叫(概率) | 会摇尾巴(概率) | 不怎么摇尾巴(概率) | 体型小(补充,不影响核心) |
| 猫 | 5 只 | 5/5=100%(P=1) | 1/5=20%(P=0.2) | 4/5=80%(P=0.8) | 5/5=100%(P=1) |
| 狗 | 5 只 | 0/5=0%(P=0) | 5/5=100%(P=1) | 0/5=0%(P=0) | 1/5=20%(P=0.2) |
求:会喵喵叫 + 不怎么摇尾巴是什么动物
P (猫) = P (狗) = 0.5
计算 1:P (猫 | 会喵喵叫 + 不怎么摇尾巴) 的分子
P (特征 | 猫) = P (会喵喵叫 | 猫) × P (不怎么摇尾巴 | 猫)
= P (会喵喵叫+不怎么摇尾巴 | 猫) × P (猫)
= (1 × 0.8) × 0.5
= 0.4
计算 2:P (狗 | 会喵喵叫 + 不怎么摇尾巴) 的分子
P (特征 | 狗) = P (会喵喵叫 | 狗) × P (不怎么摇尾巴 | 狗)
= P (会喵喵叫+不怎么摇尾巴 | 狗) × P (狗)
= (0 × 0) × 0.5
= 0
3.最小二乘法(Least Squares Method)
公式
- yi:真实值
- y^i:模型预测值
- J:总误差(损失函数)
- 目标:让 J 最小
最小二乘法 = 让 “预测值和真实值的误差平方和最小”,从而找到最优拟合直线 / 模型。
4.图灵测试(Turing Test)
图灵测试 = 判断机器是否具备 “人类智能” 的标准
让人类和机器对话,如果人类分辨不出对面是人还是机器,机器就通过测试
小华为了考试早晨买了一杯小米粥喝,让黄飞鸿蒙题目中有几个苹果,但是郭麒麟刷牙选中华为的就是干净,速度快,每次只挤5g就够用。